Pristranskost umetne inteligence pri zaposlovanju: ali sme podjetje uporabiti občutljive osebne podatke za testiranje?
Članek je namenjen podjetjem, ki razvijajo ali uporabljajo AI pri zaposlovanju. Pojasnjuje ozko izjemo za uporabo posebnih vrst osebnih podatkov pri odkrivanju pristranskosti in varovala, ki morajo veljati hkrati.
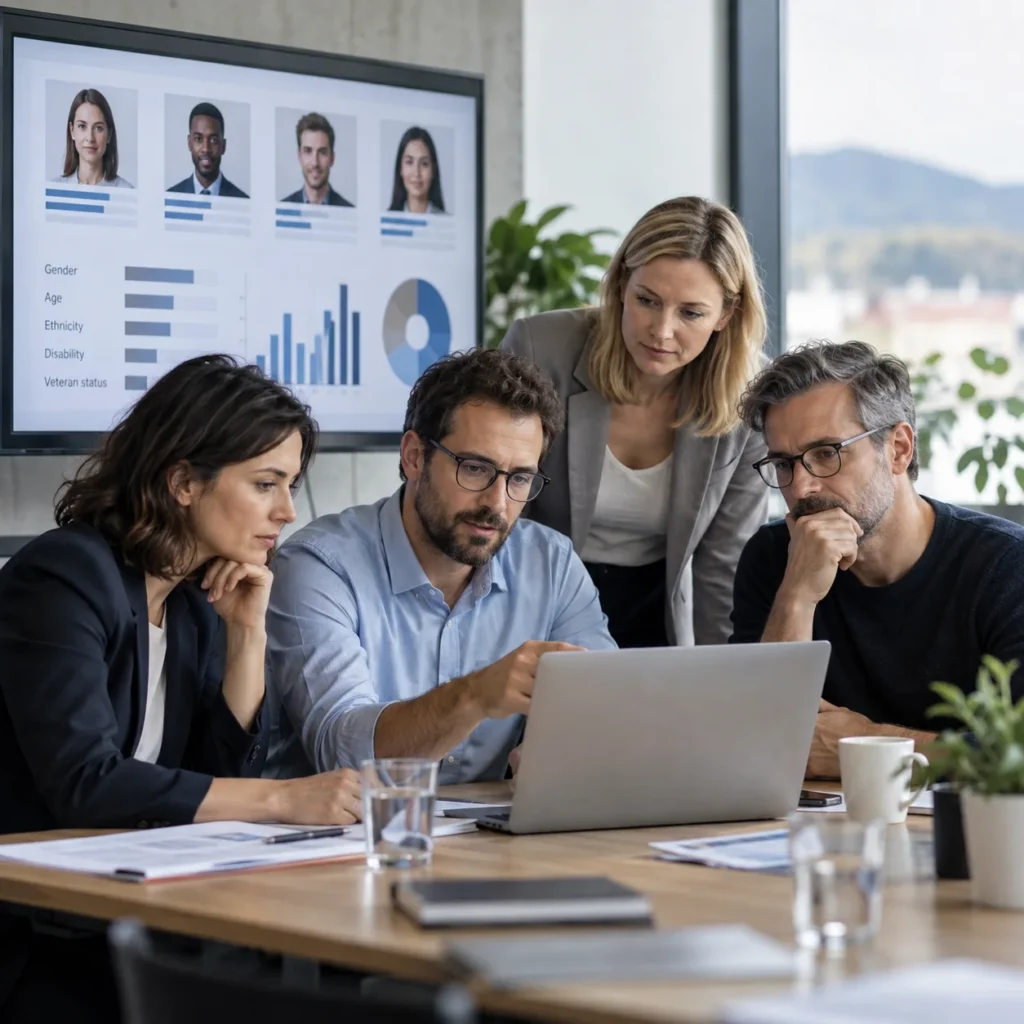 AI-ilustracija
Posebne vrste podatkov se lahko za testiranje pristranskosti AI uporabijo le izjemoma, kadar je to strogo nujno in so izpolnjena vsa zahtevana varovala.
Stanje na dan 26.09.2026: člen 4a konsolidiranega AI Act velja od 27.07.2026; GDPR se uporablja vzporedno in ni izključen.
Uvod
Podjetje želi dokazati, da njegov sistem ne diskriminira, vendar za primerjavo skupin potrebuje podatke, ki jih običajno ne sme prosto zbirati. Novi člen AI Act odpira zelo ozko pot za takšno testiranje. To ni splošno dovoljenje za zbiranje podatkov o zdravju, rasi, veri ali sindikalnem članstvu kandidatov.
Kaj so posebne vrste osebnih podatkov?
Gre za podatke, ki jim GDPR zaradi njihove občutljivosti namenja posebno varstvo. Mednje sodijo podatki o rasnem ali etničnem poreklu, političnem mnenju, verskem ali filozofskem prepričanju, članstvu v sindikatu, genetiki, biometriji za enolično identifikacijo, zdravju ter spolnem življenju ali usmerjenosti.
Njihova obdelava je načeloma prepovedana, razen če obstaja ustrezna izjema in so izpolnjeni pogoji GDPR. AI Act ne spremeni teh podatkov v običajne podatke in ne odpravi vseh drugih obveznosti.
Pri zaposlovanju je položaj posebej občutljiv zaradi neenakega razmerja moči ter neposrednega vpliva na dostop do dela. Zato mora podjetje dokazati več kot zgolj koristnost analize.
 AI-ilustracija
Preverite pravila AI pri zaposlovanju
Kaj dovoljuje novi člen 4a AI Act?
Člen omogoča izjemno obdelavo posebnih vrst osebnih podatkov za odkrivanje in popravljanje pristranskosti v povezavi z AI-sistemi, kadar je obdelava strogo nujna in veljajo predpisana varovala. Namen je omogočiti merjenje nepoštenih razlik, ki bi sicer ostale skrite.
Izjema je namensko omejena. Podatkov ni dovoljeno uporabiti za oglaševanje, profiliranje, dodatno ocenjevanje kandidatov ali druge cilje, ki niso nujni za odkrivanje oziroma popravljanje pristranskosti.
Podjetje mora odločitev dokumentirati in dokazati, zakaj manj invazivna metoda ne bi zadoščala. Priročnost ali želja po bogatejši analitiki nista dovolj.
Kaj pomeni, da mora biti obdelava strogo nujna?
Strogo nujna pomeni, da cilja ni mogoče razumno doseči z anonimnimi, sintetičnimi ali drugimi manj občutljivimi podatki. Podjetje mora alternative dejansko preučiti, ne le zapisati, da jih ni.
Vprašati se mora, ali je mogoče pristranskost preveriti z zunanjim nadzorovanim naborom, agregiranimi podatki, neodvisnim testom ali simulacijo. Če takšna metoda daje ustrezen odgovor, obdelava resničnih občutljivih podatkov morda ni dopustna.
Nujnost se presoja tudi glede količine, trajanja in dostopa. Tudi če je določena kategorija potrebna, podjetje ne sme zbirati več podatkov ali jih hraniti dlje, kot je potrebno.
Katera varovala morajo biti vzpostavljena?
Varovala so kumulativna, kar pomeni, da podjetje ne more izbrati samo najlažjih. Konsolidirano besedilo zahteva omejitev ponovne uporabe, ustrezno zaščito, stroge dostope, dokumentiranje nujnosti in izbris po končanem namenu.
Praktično to pomeni najmanj:
- natančno določen namen in obseg testa;
- dokaz, da druge metode ne zadoščajo;
- ločeno, varno okolje in psevdonimizacijo, kjer je mogoča;
- dostop le pooblaščenim osebam;
- prepoved posredovanja drugim;
- sledljivost dostopov in sprememb;
- vnaprej določen rok izbrisa;
- zapis rezultatov brez nepotrebnega ohranjanja surovih podatkov.
Če podjetje ne more uvesti vseh potrebnih varoval, izjeme ne sme uporabiti.
 AI-ilustracija
Vzpostavite register AI-orodij
Ali lahko podjetje podatke preprosto vpraša kandidate?
Ne, samo vprašanje ali privolitev kandidata ne zagotovi dopustnosti. V zaposlitvenem kontekstu je treba posebej presoditi prostovoljnost, nujnost, namen in vpliv zavrnitve.
Kandidat ne sme biti v slabšem položaju, ker podatka ne želi razkriti. Podjetje mora razložiti, kdo podatke obdeluje, zakaj, koliko časa in kako preprečuje uporabo v individualni odločitvi.
Zbiranje mora biti ločeno od izbirne ekipe, kadar je to potrebno za preprečitev zlorabe. Oseba, ki odloča o kandidatu, praviloma ne potrebuje vpogleda v občutljive podatke, uporabljene za agregirano testiranje.
Kako naj poteka test pristranskosti v praksi?
Test naj se začne z jasno hipotezo in merilom, ne z zbiranjem vseh dosegljivih podatkov. Podjetje mora določiti, katera odločitev se preverja, katere skupine so lahko prizadete ter katera razlika bi zahtevala ukrepanje.
Nato naj loči razvojno, testno in produkcijsko okolje, omeji dostop ter preveri kakovost podatkov. Slabi ali nereprezentativni podatki lahko ustvarijo lažen občutek pravičnosti.
Rezultat mora voditi v popravek: spremembo modela, podatkov, praga, procesa ali človeškega nadzora. Test, ki se konča z grafom brez odločitve, ne izpolni poslovnega namena.
Kdo mora sodelovati pri odločitvi?
Odločitev ne sme ostati le pri podatkovnem znanstveniku ali kadrovski službi. Potrebni so pravna presoja, varstvo osebnih podatkov, informacijska varnost, lastnik procesa ter tehnična ekipa.
Pri pomembnih tveganjih je smiselna neodvisna validacija. Podjetje naj vnaprej določi, kdo lahko odobri obdelavo, kdo dostopa do podatkov, kdo presoja rezultat in kdo potrdi izbris.
Če je sistem ponudnikov, mora pogodba zagotoviti potrebne informacije in nadzor. Ponudnikova splošna izjava o »fairness« ne dokazuje skladnosti konkretne uporabe podjetja.
Pomembno: Izjema za testiranje pristranskosti ni podlaga za uporabo občutljivih podatkov pri individualnem razvrščanju ali ocenjevanju kandidatov.
Pravičnost sistema se ne dokazuje z več podatki, temveč z nadzorovano in nujno uporabo
Paradoks testiranja pristranskosti je očiten: za zaščito ranljive skupine lahko potrebujemo podatek, ki bi jo ob napačni uporabi še bolj izpostavil. Zato izjema zahteva strogo omejitev namena in močno ločitev med testom ter individualnim odločanjem.
Pogosta napaka je začeti z zbiranjem in šele pozneje iskati razlog. Pravilni vrstni red je nasproten: najprej konkretno tveganje, nato presoja alternativ, šele nato najmanjši potreben nabor podatkov.
Podjetjem priporočamo, da vsak tak projekt obravnavajo kot časovno omejeno, dokumentirano izjemo. Če postane trajna zbirka občutljivih profilov kandidatov, je projekt verjetno zapustil namen, zaradi katerega je bil sploh dovoljen.
Viri
- EUR-Lex: Konsolidirano besedilo Uredbe (EU) 2024/1689, 27.07.2026.
- Evropska komisija: AI Omnibus enters into force, dostop 26.09.2026.
- Evropski odbor za varstvo podatkov: Opinion 28/2024 on AI models, sprejeto 17.12.2024.